김우진
운영 중인 서버의 조회 API 하나가 부하 테스트에서 p95 7초를 찍었어요. 요청이 실패한 건 아니었어요. 그냥 느렸어요. 초당 처리량도 16.6 RPS를 넘기지 못했고요. 이 정도면 “돌아가긴 한다”와 “쓸 만하다” 사이에 분명한 간극이 있었어요. 7초를 그대로 둘 수는 없었습니다.
DB를 조회하는 API였으니 자연스럽게 DB부터 의심했어요. 그런데 막상 들여다보니 DB CPU는 꽤 한가했어요. 붐비는 쪽은 오히려 애플리케이션이었어요.
HikariCP 풀 크기는 4였고, 그 네 개의 연결을 빌리기 위해 줄 서 있는 요청이 최대 36개까지 쌓여 있었거든요. 말 그대로 연결 네 개를 두고 서른여섯 개가 기다리는 그림이었어요.
여기까지만 보면 진단은 너무 쉬워 보여요.
“DB는 놀고 있는데 통로가 좁다. 연결만 늘리면 된다.”
저도 처음엔 그렇게 생각했어요. 다만 바로 그렇게 결론 내리기엔 한 가지가 걸렸어요. 정말 연결이 병목이라면, 풀을 늘렸을 때 DB가 그만큼 더 많은 일을 끝내야 해요. 그런데 DB는 이미 여유로웠어요. 연결을 더 주는 일과 요청을 더 빨리 끝내는 일이 정말 같은 방향으로 움직일지는 아직 확인되지 않은 상태였죠.
그래서 풀 크기를 건드리기 전에, 다른 변수 하나를 먼저 바꿔보기로 했어요.
연결을 기다리는 요청들을 어떻게 다루는지부터요.
그게 Java 21의 Virtual Thread였어요.
가상 스레드 자체를 처음부터 길게 설명하진 않으려고 해요. 이 글에서는 실험을 따라가는 데 필요한 만큼만 짚고 갈게요. 자세한 내용은 꼭 한 번 별도로 찾아보시면 좋겠습니다.
기존 구조에서는 요청이 DB 연결을 기다리거나, 쿼리 결과를 기다리는 동안에도 플랫폼 스레드 하나를 계속 붙잡고 있었어요. 플랫폼 스레드는 OS 스레드와 1:1로 연결되어 있으니, 기다리는 요청이 많아질수록 그만큼의 OS 스레드도 유지돼야 해요.
대기 중이라고 해서 CPU를 계속 태우는 건 아니지만, 요청 하나가 스레드 하나를 오래 점유하는 구조라는 사실은 그대로예요. 전통적인 자바의 request-per-thread 모델이죠.
Virtual Thread는 이 대기를 훨씬 가볍게 다뤄요. JVM이 가상 스레드를 플랫폼 스레드 위에 올려 실행하다가, 소켓 I/O나 JDBC처럼 JVM이 다룰 수 있는 블로킹 지점에서 멈추면 둘을 분리해요. 실행을 맡고 있던 플랫폼 스레드, 즉 캐리어 스레드는 그동안 다른 가상 스레드를 실행할 수 있고요.
우리 API에는 이미 기다리는 구간이 많았어요. 연결을 획득하기 전에도 기다렸고, 쿼리를 보낸 뒤에도 기다렸어요. 그렇다면 이 대기를 가상 스레드로 바꿨을 때, 같은 연결 수로 더 많은 요청을 처리할 수 있을까를 먼저 확인해 볼 만했어요.
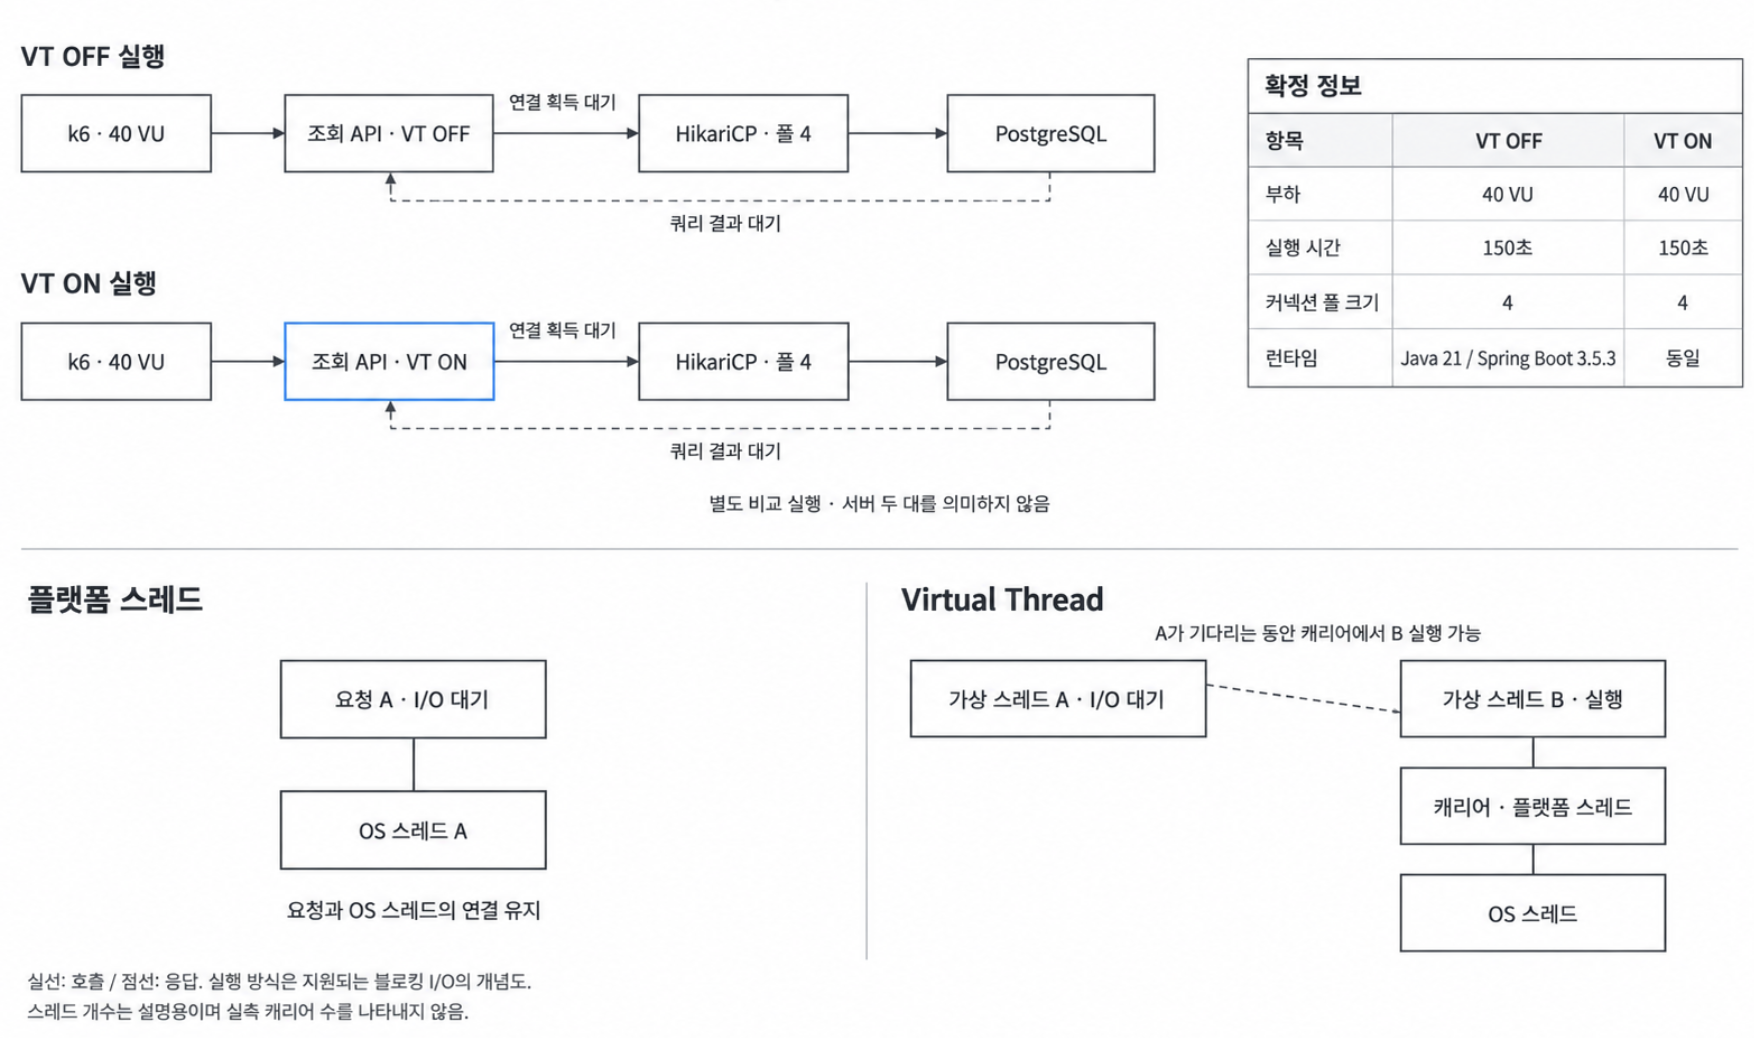
Java 21, Spring Boot 3.5.3 환경이었기 때문에 설정은 한 줄이면 됐어요.
spring.threads.virtual.enabled=true
테스트는 로컬 Docker 환경에서 진행했어요. 컨테이너 자원은 운영 태스크와 맞춰 0.5 vCPU, 1GB로 제한했고, 그 상태에서 VT만 켜고 껐어요. 알고 싶은 건 절대 성능이 아니라, 다른 조건은 그대로 둔 채 설정 하나가 어떤 차이를 만드는지였거든요.
대상은 성격이 다른 조회 API 세 개였어요. 아래에서는 조회 A, B, C라고 부를게요. 각 API를 40 VU로 150초씩 실행했어요.
VU는 같은 시나리오를 반복하는 가상 사용자예요. 이번 테스트는 사용자 수를 고정했기 때문에, 응답이 빨라지면 같은 사용자가 더 빨리 다음 요청을 보낼 수 있어요. 즉, 이 실험은 “같은 동시 사용자 조건에서 얼마나 더 빨리 끝내는가”를 비교하는 테스트에 가까워요.
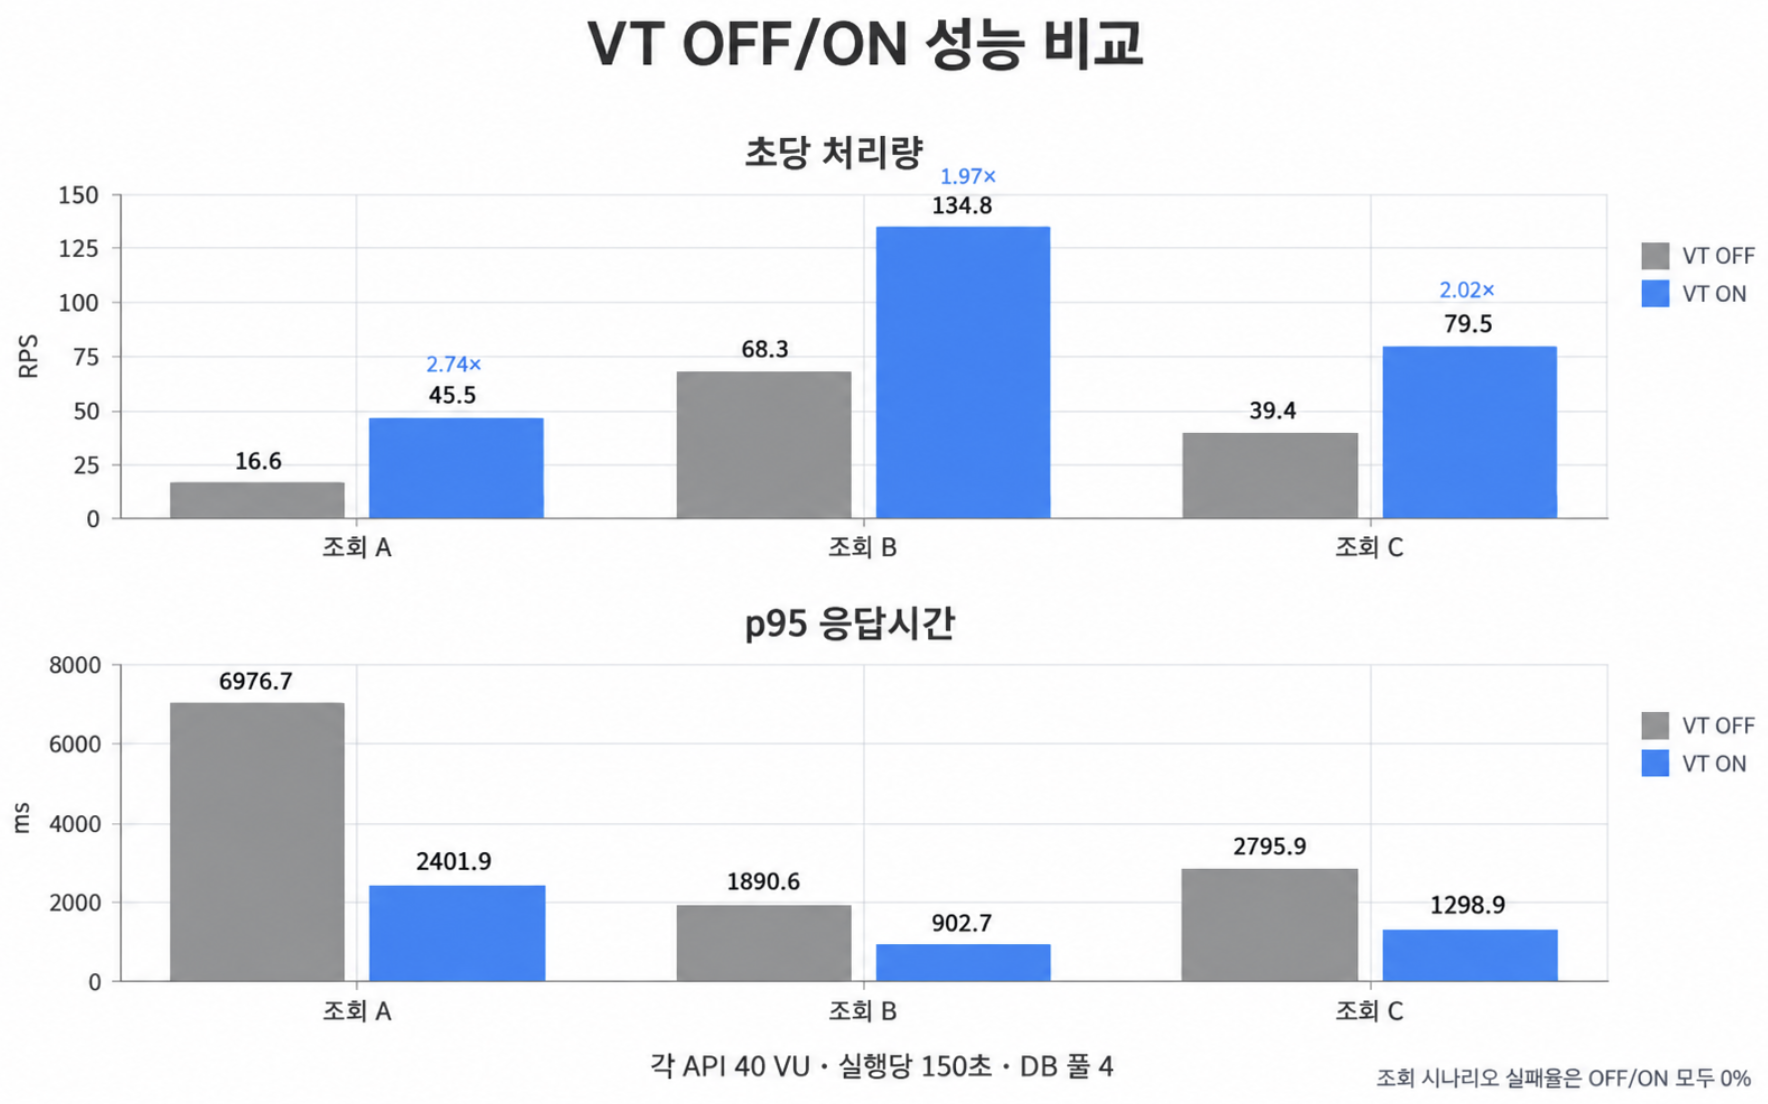
가장 문제가 됐던 조회 A는 16.6 RPS에서 45.5 RPS로 올라갔어요. 거의 2.74배예요. p95는 7초 가까이 나오던 것이 2.4초 수준으로 내려왔고요. 나머지 조회 B, C도 방향은 같았어요. 처리량은 두 배 안팎으로 늘었고, p95는 절반 가까이 줄었어요. 실패율은 전후 모두 0%였고요.
이쯤 되면 결과 자체는 꽤 명확했어요. 적어도 조회 경로에서는 Virtual Thread가 체감 가능한 개선을 만들어냈어요.
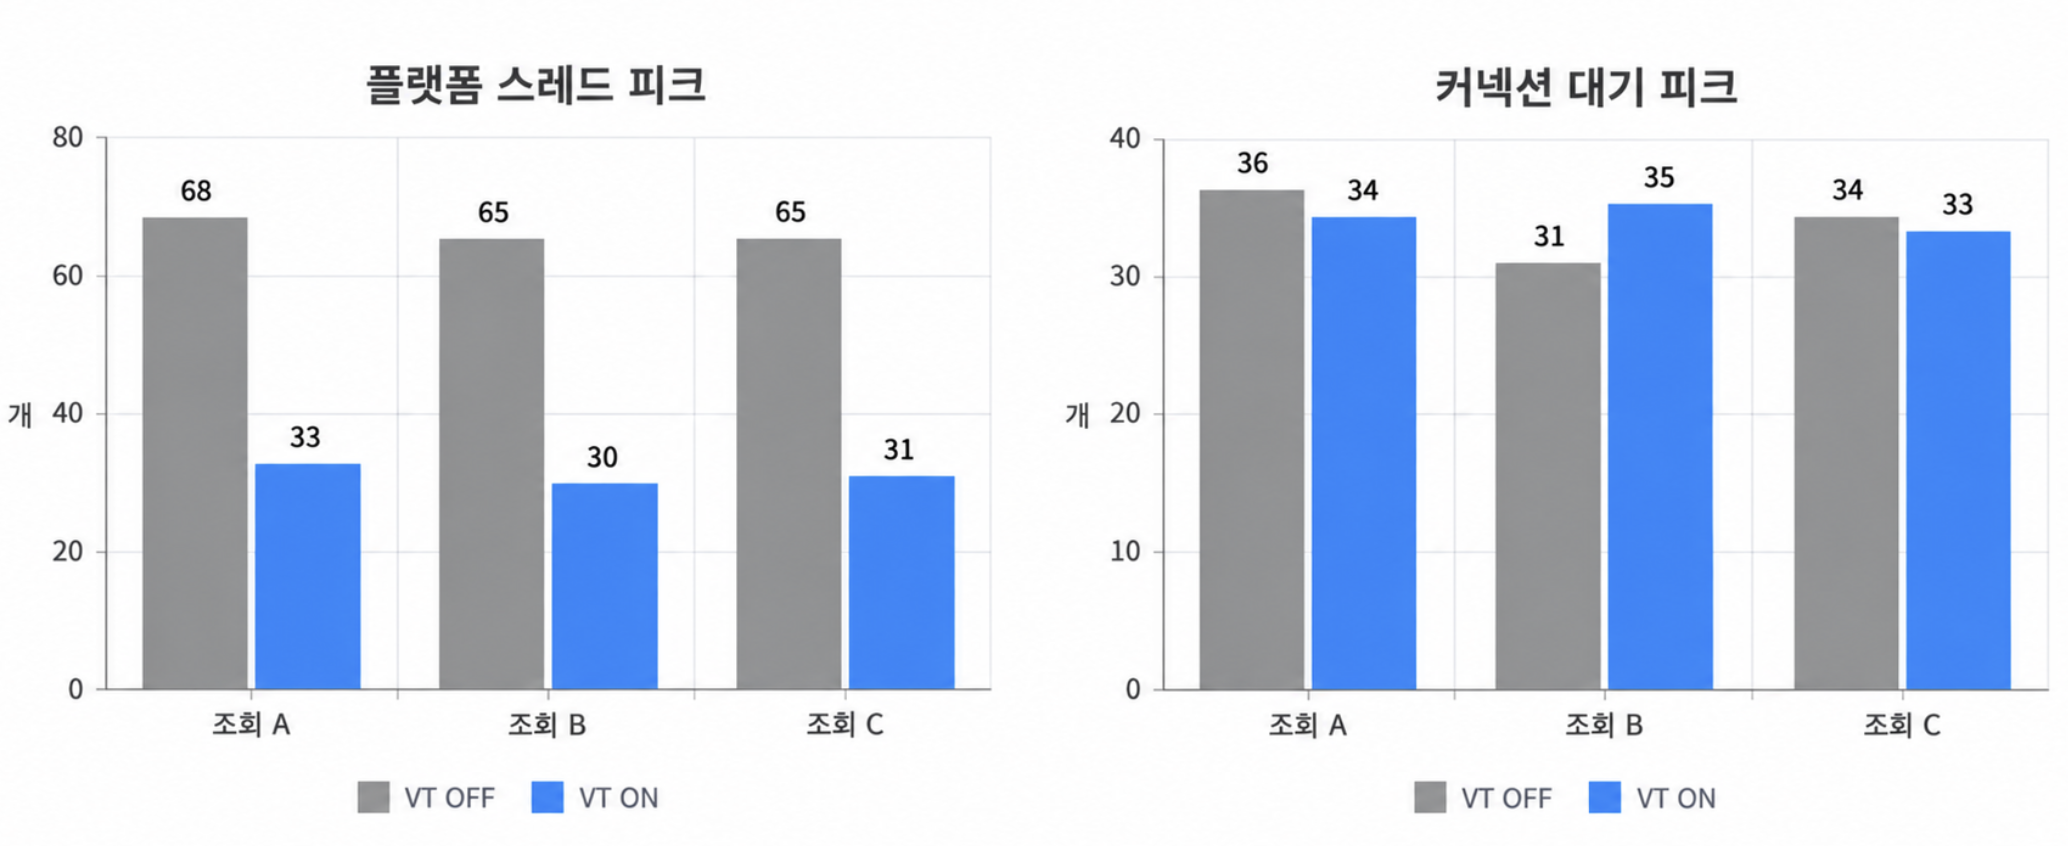
내부 지표를 보면 이 변화가 더 흥미로워져요. 플랫폼 스레드 피크는 확실히 줄었어요. 조회 A 기준으로 68개에서 33개까지 내려왔고, B와 C도 비슷했어요. 그런데 예상과 다르게, 커넥션 대기 피크는 거의 그대로였어요. 조회 A는 36에서 34, 사실상 차이가 없는 수준이었어요.
처음 세웠던 가설과 어긋나는 장면이 여기서 나왔어요.
풀 크기도 그대로 4개, 커넥션 대기 줄도 거의 그대로인데 처리량만 2.74배가 됐어요.
즉, 이 개선은 “연결을 더 많이 빌려줘서” 생긴 게 아니었어요. 연결을 빌리는 층은 거의 그대로였는데, 그 위에서 요청을 다루는 방식이 달라지면서 결과가 바뀐 거예요.
여기서 리틀의 법칙으로 보면 감이 더 잘 잡혀요. 연결이 네 개이고 그 연결이 쉬지 않고 돈다고 가정하면, 처리량은 결국 연결 하나를 평균 얼마나 오래 쥐고 있느냐에 반비례해요. 16.6 RPS일 때는 연결 하나를 평균 240ms 정도 쥐고 있는 셈이고, 45.5 RPS일 때는 약 88ms 수준이에요. 같은 네 개의 연결인데, 결과적으로 연결 하나당 점유 시간이 훨씬 짧아진 것이죠.
그럼 왜 짧아졌을까요. 이때 CPU를 같이 봤어요. VT를 켜기 전이나 후나 애플리케이션 CPU는 사실상 한계치에 붙어 있었어요. 0.5 vCPU 제한이니까, 관측상으로는 거의 50% 수준이었고요. 둘 다 CPU는 꽉 차 있는데, VT ON 쪽이 훨씬 많은 요청을 끝냈어요. 이건 결국 요청 하나를 처리하는 데 드는 CPU 비용이 줄었다는 뜻으로 읽을 수 있었어요.
직접 컨텍스트 스위칭 횟수를 VT OFF/ON으로 정밀 계측한 건 아니에요. 다만 눈앞의 숫자는 꽤 일관됐어요. 플랫폼 스레드 피크는 68개에서 33개로 줄었고, 같은 CPU 한계 안에서 처리량은 2.74배가 됐어요.
반 개짜리 코어 위에서 플랫폼 스레드 수십 개가 실행 순서를 두고 경쟁하던 비용이 적지 않았고, VT를 켰을 때는 실제 OS 스레드 층의 부담이 줄어든 것으로 보는 게 가장 자연스러웠어요.
그래서 이 단계에서는 커넥션 대기를 없애는 걸 목표로 두지 않았어요. 우리가 확인하고 싶었던 건 훨씬 단순했어요.
풀 크기를 그대로 둔 상태에서, 더 적은 플랫폼 스레드로 더 많은 조회 요청을 처리할 수 있는가?
답은 “그렇다”였어요. 그리고 바로 이 지점부터, “연결이 병목이다”라는 첫 진단은 흔들리기 시작했어요.
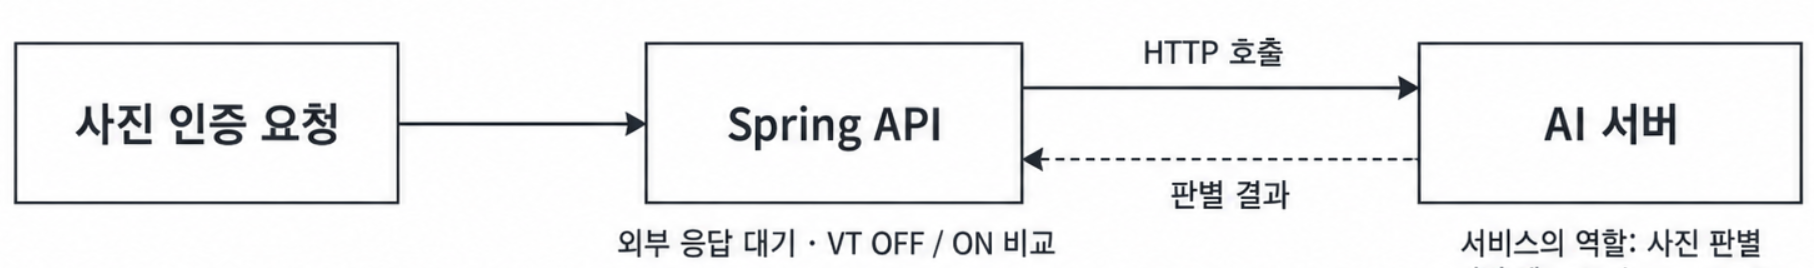
조회 API만 본 건 아니었어요. 서비스 안에는 AI 추론을 호출하는 경로도 있었어요. 사진을 판별하는 건 별도의 모델 서버가 맡고, 우리 Spring API는 그 서버를 HTTP로 호출해 결과를 기다리는 구조였어요.
이 경로도 사실 본질은 비슷해요. 모델의 연산을 API 밖으로 분리했다고 해서, 우리 쪽 요청이 끝나는 건 아니거든요. 사용자 입장에서는 여전히 한 번의 요청이고, API 입장에서도 모델 서버가 결과를 돌려주기 전까지는 작업이 끝나지 않아요. 결국 여기서도 우리가 다루는 건 대기였어요. 모델을 더 빠르게 만드는 문제가 아니라, 외부 계산을 기다리는 동안 우리 API가 요청을 얼마나 싸게 들고 있을 수 있느냐의 문제였죠.
Virtual Thread는 이 경로에서도 같은 방식으로 의미가 있었어요. 외부 HTTP 응답을 기다리는 동안 캐리어 스레드를 다른 작업에 넘길 수 있으니까요.
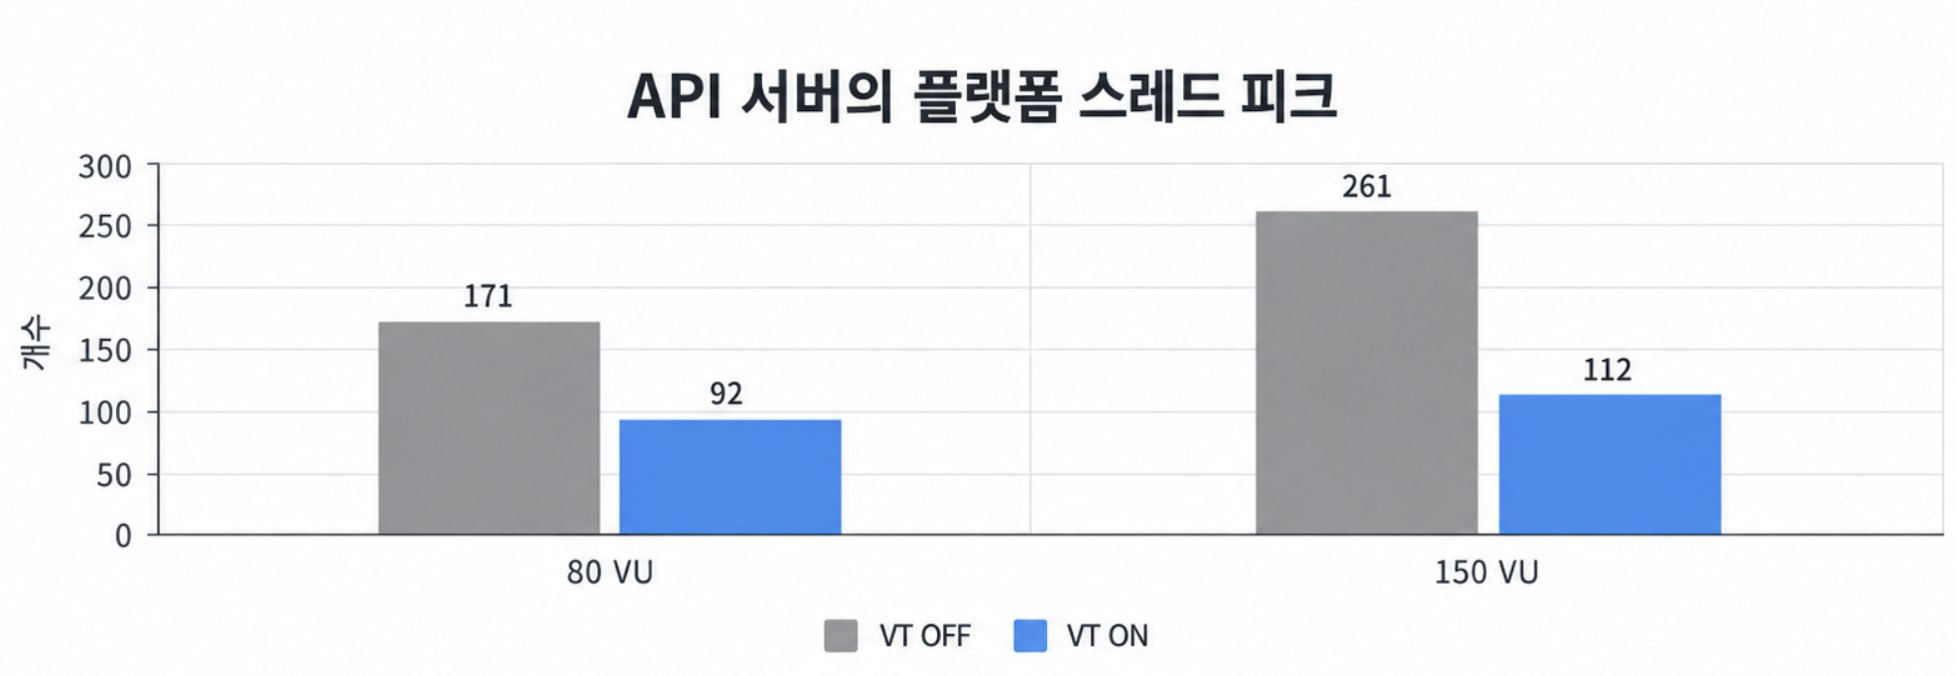
그래서 이 구간에서는 모델 자체의 성능보다, 호출하는 API의 플랫폼 스레드 수를 봤어요. 80 VU에서는 플랫폼 스레드 피크가 171개에서 92개로, 150 VU에서는 261개에서 112개로 줄었어요. 조회 경로에 이어 외부 HTTP 호출 경로에서도, VT가 대기 구간을 다루는 방식에 변화를 만든다는 점은 분명히 확인됐어요.
즉, Virtual Thread의 효용은 “DB 조회”라는 특정 상황에만 국한되지 않았어요. 외부 응답을 기다리는 요청이 많은 구조라면, 그 대기를 어떻게 들고 있느냐 자체가 성능에 꽤 큰 차이를 만들 수 있다는 걸 보여줬어요.
여기서 미뤄두었던 질문으로 다시 돌아왔어요. VT로 처리량이 오른 건 확인했어요. 그런데 커넥션 대기는 여전히 많았어요. 그렇다면 이제 정말로 풀을 늘려보면 어떻게 될까요?
이번에는 VT는 켠 채로 두고, 커넥션 풀 크기만 4 → 8 → 16 → 32로 바꿨어요. 대상은 조회 A였고, 부하는 64 VU였어요. 앞선 40 VU 비교와는 별도의 실험이었어요.
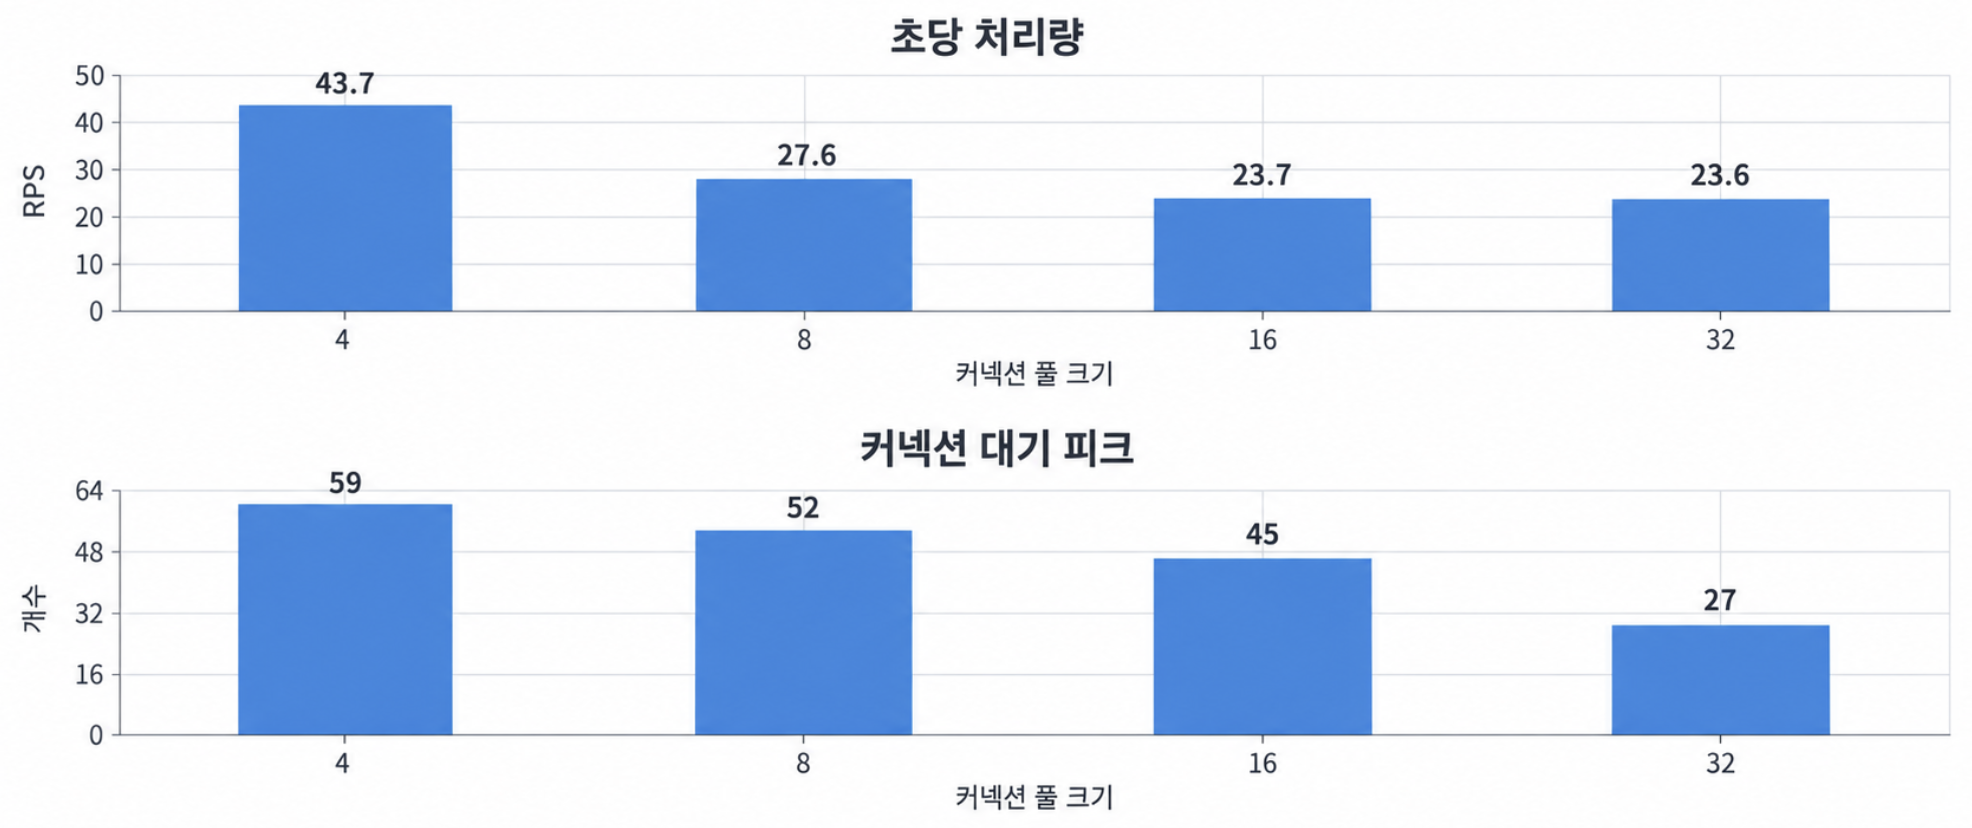
결과는 예상과 정반대였어요. 풀을 4에서 32로 늘리자 커넥션 대기 피크는 59에서 27로 줄었어요. 그런데 처리량은 43.7 RPS에서 23.6 RPS로 떨어졌어요.
기다리는 줄은 줄었는데, 정작 더 적은 요청을 끝내고 있었던 거예요.
물론 절대값 자체는 조금 흔들렸어요. 0.5 vCPU 환경이라 편차가 작지 않았거든요. 실제로 풀 4를 두 번 측정했을 때 43.7과 32.3처럼 차이가 있었어요. 그래도 중요한 건 방향이었어요. 풀 32는 두 번 다 그보다 낮았고, 풀을 늘릴수록 나빠진다는 추세는 흔들리지 않았어요.
이 결과를 보고 나니, 처음 봤을 때 그럴듯했던 “연결이 병목”이라는 진단은 더 버티기 어려워졌어요.
정말 연결이 병목이라면, 연결을 늘렸을 때 DB가 더 많은 일을 끝내야 해요. 그런데 현실은 반대였거든요.
앱 쪽 숫자만 보고 판단하고 싶진 않았어요. 그래서 DB가 실제로 끝낸 작업량도 같이 봤어요.
| 풀 크기 | 사용 중인 커넥션 피크 | DB 커밋 트랜잭션/초 | DB CPU 평균 |
|---|---|---|---|
| 4 | 4 | 131.2 | 7.1% |
| 8 | 8 | 84.3 | 5.7% |
| 16 | 16 | 74.7 | 6.8% |
| 32 | 31 | 74.7 | 8.2% |
커넥션 사용량은 부하 중 피크, DB 커밋 트랜잭션/초는 xact_commit 증가량을 관측 시간으로 나눈 값이에요.
풀 32에서는 실제로 사용 중인 연결이 31개까지 올라갔어요. 그러니 “설정만 커지고 실제로는 안 썼다”는 이야기는 아니에요. 그런데 DB가 커밋한 트랜잭션은 초당 131건에서 75건 수준으로 줄었고, DB CPU는 계속 한 자릿수에 머물렀어요.
이걸 보면 분명해져요.
앱이 연결을 많이 빌려간 것과 DB가 더 많은 일을 끝낸 것은 같은 말이 아니에요.
HikariCP가 “사용 중”으로 세는 건, 앱이 연결을 빌려가 아직 반납하지 않았다는 뜻이에요. 그 시간의 대부분이 DB에서 쿼리를 실행하는 시간일 수도 있지만, 아닐 수도 있어요. 결과를 읽고, 객체로 만들고, 응답을 구성하는 애플리케이션 CPU 시간이 더 길 수도 있죠.
이번 실험에서는 바로 그 그림이었어요. 연결은 더 많이 잡고 있었지만, DB는 더 많은 일을 하지 않았고, 오히려 앱 전체 처리량은 떨어졌어요. 연결을 늘려도 병목이 풀리지 않았다는 뜻이에요. 병목이 연결이 아니라 애플리케이션 CPU 쪽에 더 가까웠다는 쪽이 훨씬 설명력이 높았어요.
이 모양은 사실 낯설지 않아요. 동시성을 높였을 때 처리량이 정점을 지나 오히려 떨어지는, 이른바 retrograde 구간처럼 보였어요. CPU 여유가 거의 없는 0.5 vCPU 환경에서는 그런 지점이 아주 빨리 찾아와도 이상하지 않아요. 우리 실험에서는 풀 4가 이미 그 근처였고요.
두 실험을 나란히 놓고 보면 결론은 꽤 선명해져요.
둘 다 “동시성”과 관련된 설정이라 한꺼번에 키워야 할 것처럼 보일 수 있어요. 그런데 실제로는 전혀 달랐어요. VT는 요청 하나를 처리하는 비용을 낮춰줬고, 커넥션 풀 확대는 남아 있지 않은 CPU 위에 더 많은 일을 얹는 결과에 가까웠어요.
그래서 우리는 VT의 개선은 가져가고, 풀은 4로 유지하기로 했어요.
최종적으로 조회 경로에 선택한 조합은 Virtual Thread ON + HikariCP 풀 크기 4였어요. 도입 판단에 사용한 조회 세 개의 전후 결과를 모으면 아래와 같아요.
| API | 처리량 (RPS) | 처리량 배율 | p95 (초) | p95 감소율 | 플랫폼 스레드 피크 |
|---|---|---|---|---|---|
| 조회 A | 16.6 → 45.5 | 2.74배 | 6.98 → 2.40 | 65.6% | 68 → 33 |
| 조회 B | 68.3 → 134.8 | 1.97배 | 1.89 → 0.90 | 52.3% | 65 → 30 |
| 조회 C | 39.4 → 79.5 | 2.02배 | 2.80 → 1.30 |
VT OFF → ON 순서, 각 API 40 VU·150초, 동일 자원 제한과 풀 크기 4.
p95 감소율은 반올림 전 값으로 계산했어요.
처음 p95 7초를 찍던 조회 A는 2.4초까지 내려왔어요. 플랫폼 스레드 피크도 68개에서 33개로 줄었고요.
처음에는 “연결 네 개가 너무 적어서 밀린다”고 생각했어요. 그런데 끝까지 실험하고 나니, 부족했던 건 연결이 아니라 반 개짜리 코어 위에서 요청을 다루는 방식이었어요. 연결은 한가한 DB로 가는 통로였고, 정작 더 부족했던 건 그 통로 뒤에서 요청을 처리하는 애플리케이션 CPU였어요.
그래서 이번 결론은 꽤 단순해요.
커넥션 수는 그대로 두고, 요청을 다루는 방식을 바꾸자 처리량은 최대 2.74배까지 올라갔어요.
동시성 설정을 올린다고 언제나 처리량이 오르는 건 아니에요. CPU가 남아 있을 때는 잘 먹히지만, CPU가 이미 병목이면 동시성을 늘리는 일은 결국 같은 파이를 더 잘게 나눠 먹는 일에 가까워져요. 이번 실험에서 커넥션 대기는 그저 가장 먼저 눈에 들어온 숫자였을 뿐이에요. 진짜 제약은 다른 곳에 있었고, Virtual Thread는 바로 그 지점을 건드리고 있었어요.
| 65 → 31 |

